共分散の求め方を完全攻略!公式の意味とExcel計算・相関係数の違い
高校数学の「データの分析」や統計検定、ビジネスのデータサイエンス実務において、最初の大きな壁となりやすい概念が「共分散(Covariance)」です。2つの変数がどのような連動性を持っているかを測る基礎統計量ですが、複雑なシグマ($\sum$)記号や見慣れない計算手順に戸惑い、苦手意識を持つ学習者は少なくありません。
共分散の計算は、公式を丸暗記しようとすると難解に見えますが、その構造は極めてシンプルです。本稿では、共分散が持つ「幾何学的な意味」から、手計算の5つの手順、実務で頻用されるExcelでの計算関数、さらには相関係数への発展まで、データ分析の現場で役立つ実践知を網羅して分かりやすく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:共分散の本質は「偏差の積の平均」であり、2つのデータが同じ方向に動くか(正の相関)、逆方向に動くか(負の相関)を数値化する指標である。
- 要点2:共分散は測定単位の影響を直接受けるため、関係性の強弱を客観的に比較するには無次元化した「相関係数の求め方」を理解する必要がある。
- 要点3:Excelで処理する際は、全データを対象とする「COVARIANCE.P関数」と標本抽出を前提とする「COVARIANCE.S関数」の明確な使い分けが必須となる。
【疑問を即解消】共分散の求め方と公式の意味を図解で直感理解
共分散の求め方でつまずいてしまう最大の理由は、「数式が何を意味しているのか」という視覚的イメージを持てないまま計算に進んでしまう点にあります。難解に見える共分散公式ですが、日本語に翻訳するとその実体は極めて明快です。
2つの変数 $X$ と $Y$ について、データ数が $n$ 個ある場合の共分散 $Cov(X, Y)$(または $s_{xy}$)の基本公式は以下の通り定義されます。
Cov(X, Y) = (1 / n) × Σ [ (x_i - Xの平均) × (y_i - Yの平均) ]
この数式を言葉で要約したものが、統計学で頻出する「偏差の積の平均」というフレーズです。
散布図を思い浮かべてください。横軸に $X$、縦軸に $Y$ を取り、データ全体の「重心」となる平均値の交点を原点(0,0)に見立てて座標平面を4つのエリアに分割します。
- 右上エリア(第1象限):$X$ も $Y$ も平均より大きい $\rightarrow$ (プラス)×(プラス)=プラス
- 左下エリア(第3象限):$X$ も $Y$ も平均より小さい $\rightarrow$ (マイナス)×(マイナス)=プラス
- 左上エリア(第2象限):$X$ は平均未満で $Y$ は平均以上 $\rightarrow$ (マイナス)×(プラス)=マイナス
- 右下エリア(第4象限):$X$ は平均以上で $Y$ は平均未満 $\rightarrow$ (プラス)×(マイナス)=マイナス
各データが平均からどれだけ離れているか(偏差)を掛け算すると、右上がりの配置にあるデータはすべてプラスの面積を生み出し、右下がりの配置にあるデータはマイナスの面積を生み出します。それらすべての面積を足し合わせてデータ数で割った「平均的な面積」こそが共分散の正体です。
面積の合計がプラスに傾けば正の相関(一方が増えればもう一方も増える傾向)、マイナスに傾けば負の相関(一方が増えればもう一方は減る傾向)が存在すると判断できます。0に近ければ、2変数間に直線的な関係性がないことを意味します。

【統計学基礎例題】手計算で迷わない!5ステップの完全計算手順
手計算における計算ミスを防ぐためには、体系化された表を作成し、1ステップずつ着実に処理していくアプローチが最も確実です。ここでは高校数学データの分析や統計検定3級〜2級で定番の小規模データを用いた統計学基礎例題を実際に解き進めます。
【例題データ】5人の生徒の「1週間の勉強時間(時間):$X$」と「テストの得点(点):$Y$」
- 生徒A:勉強時間 2時間 / 得点 40点
- 生徒B:勉強時間 4時間 / 得点 60点
- 生徒C:勉強時間 6時間 / 得点 50点
- 生徒D:勉強時間 7時間 / 得点 70点
- 生徒E:勉強時間 11時間 / 得点 80点
ステップ1:各変数の平均値を算出する
$X$ の平均値 $\bar{x} = (2 + 4 + 6 + 7 + 11) \div 5 = 30 \div 5 = \mathbf{6.0\text{時間}}$
$Y$ の平均値 $\bar{y} = (40 + 60 + 50 + 70 + 80) \div 5 = 300 \div 5 = \mathbf{60.0\text{点}}$
ステップ2:各データの偏差(平均との差)を求める
- 生徒A:$x$ の偏差 $2 - 6 = -4$ / $y$ の偏差 $40 - 60 = -20$
- 生徒B:$x$ の偏差 $4 - 6 = -2$ / $y$ の偏差 $60 - 60 = 0$
- 生徒C:$x$ の偏差 $6 - 6 = 0$ / $y$ の偏差 $50 - 60 = -10$
- 生徒D:$x$ の偏差 $7 - 6 = +1$ / $y$ の偏差 $70 - 60 = +10$
- 生徒E:$x$ の偏差 $11 - 6 = +5$ / $y$ の偏差 $80 - 60 = +20$
ステップ3:偏差同士の積を算出する
- 生徒A:$(-4) \times (-20) = \mathbf{+80}$
- 生徒B:$(-2) \times 0 = \mathbf{0}$
- 生徒C:$0 \times (-10) = \mathbf{0}$
- 生徒D:$(+1) \times (+10) = \mathbf{+10}$
- 生徒E:$(+5) \times (+20) = \mathbf{+100}$
ステップ4:偏差の積の合計を求める
偏差の積の合計 $= 80 + 0 + 0 + 10 + 100 = \mathbf{190}$
ステップ5:データ数(n=5)で割り、共分散を導出する
共分散 $Cov(X, Y) = 190 \div 5 = \mathbf{38.0}$
計算結果が $+38.0$ という正の値になったことから、勉強時間とテストの得点の間には「勉強時間が長くなるほど点数も高くなる」という正の連動性が確認できます。
【徹底比較】分散と共分散の違い・相関係数への発展を整理
統計学を学ぶ過程で多くの人が混同しやすいのが、「分散」と「共分散」、そして「相関係数」の役割分担です。それぞれの性質と実務上の位置づけを以下の比較表で整理しました。
| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 分散(Variance) | 単一変数内の散らばり度合い(偏差の2乗平均) | 常に0以上の値を取る(単位は元の単位の2乗) | 1変数のばらつきを捉える基本指標。共分散の計算基盤となる。 |
| 共分散(Covariance) | 2変数間の連動方向(偏差の積の平均) | 負の無限大〜正の無限大(単位は2変数の単位の積) | 連動の「方向(符号)」は分かるが、単位に依存するため強弱比較は不可能。 |
| 相関係数(Correlation) | 共分散を各変数の標準偏差の積で割った無次元化数値 | -1.00 〜 +1.00 の範囲に規格化 | 実務で最も重視される指標。単位の壁を越えて関係の強さを客観比較できる。 |
共分散が抱える最大の弱点:「単位(スケール)」の壁
分散と共分散の違いを理解した上で見落としてはならないのが、共分散の意味と単位の制約です。先ほどの例題では、共分散の値は「$38.0\text{ 時間}\cdot\text{点}$」でした。しかし、もし勉強時間を「分」に変換して計算し直すと、数値は一気に60倍の「$2280$」へと膨れ上がります。
データ自体の関係性は全く変わっていないにもかかわらず、測定単位を変えただけで数値が桁違いに大きくなってしまうのです。そのため、共分散の値を見て「数値が1000を超えているから非常に強い相関がある」と結論づけることは統計学的に明確な誤りとなります。
相関係数の求め方:共分散の規格化
この単位依存の欠点を克服するために考案されたのが相関係数の求め方(ピアソンの積率相関係数 $r$)です。共分散をそれぞれの変数の標準偏差($s_x, s_y$)で割ることで、単位を打ち消して無次元化します。
r = Cov(X, Y) / ( s_x × s_y )
これにより、どのような単位のデータであっても数値が必ず「$-1 \leqq r \leqq 1$」の範囲に収まり、0.7以上なら強い正の相関、-0.7以下なら強い負の相関といった具合に、関係性の強弱を統一基準で判定できるようになります。

【実務即戦力】Excel共分散関数の使い方|COVARIANCE.PとCOVARIANCE.Sの落とし穴
ビジネスの現場やデータ分析業務では、大量のデータセットを手計算することは現実的ではありません。Microsoft Excelを活用すれば瞬時に共分散を算出できますが、関数選定において多くの実務者が陥る罠が存在します。
Excelには共分散を計算する専用のExcel共分散関数として主に2種類が用意されています。
- =COVARIANCE.P(配列1, 配列2):母集団全体の共分散(母共分散)を計算。分母をデータ数「$n$」で割る。
- =COVARIANCE.S(配列1, 配列2):母集団から抽出された標本データから母共分散を推定(標本共分散)。分母を「$n - 1$」(自由度)で割る。
※旧バージョンの互換性関数として `=COVAR` も残されていますが、これは内部的に `COVARIANCE.P` と同一の処理を行います。現行の分析では非推奨となっており、意図を明確にするためにも末尾に `.P` または `.S` がついた関数を使用するのが鉄則です。
実務でどちらの関数を選ぶべきか?
高校数学の試験対策や、社内全社員のデータ・全数検査データをそのまま分析する場合はCOVARIANCE.P関数を使用します。一方で、一部の顧客アンケートや実験サンプルから市場全体の関係性を推測する統計学的アプローチを取る場合は、不偏推定量として分母を $n-1$ で計算する `COVARIANCE.S` を選択しなければ数値に歪みが生じます。
多次元データを一括処理する「共分散行列の計算」
変数が3つ以上(例:売上、広告費、来店客数、気温など)に及ぶ場合、2変数ずつの組み合わせを一つずつ手作業で計算するのは非効率です。Excelの「データ分析」アドイン(データタブ $\rightarrow$ データ分析 $\rightarrow$ 共分散)を活用すると、以下のような共分散行列の計算テーブルを一瞬で出力できます。
共分散行列の対角線部分には「各変数自身の分散」が並び、それ以外のセルには「2変数間の共分散」が対称に配置されます。この行列は、主成分分析(PCA)や多変量解析、ポートフォリオ理論によるリスク分散計算など、現代の高度データ分析の土台として機能しています。
【実態検証】初学者が必ずハマる3大トラップとネットの誤解
教育現場や社内データリテラシー研修の受講生から寄せられる疑問を検証すると、共分散を取り扱う際に共通して陥りやすい「典型的な誤解」が3つ浮き彫りになります。
1. 「共分散=0」は必ずしも「無関係」を意味しない
共分散や相関係数が検知できるのは、あくまで「直線的な関係性(線形関係)」のみです。例えば、二次関数の放物線のように「$Y = X^2$」という極めて明確な規則性があっても、$X$ が $-3, -2, -1, 0, 1, 2, 3$ と対称に分布している場合、プラスの積とマイナスの積が完全に相殺され、共分散も相関係数も「0」になります。
「共分散が0だから関係がない」と早合点せず、必ず事前に散布図と相関関係を目視で確認するデータ探索(EDA)のプロセスを省略してはなりません。
2. 外れ値(異常値)1個で符号すら逆転する脆弱性
共分散は「平均値」と「引き算(偏差)」をベースに計算するため、外れ値に対して非常に脆弱です。仮に99件のデータが綺麗な右上がりの正の相関を示していても、極端に外れたデータ(例:入力ミスによる桁違いの数値)が1件混ざるだけで、全体の共分散がマイナスに転落することがあります。
異常値のクリーニングを行わずに計算を実行することは、誤った意思決定を招く重大なリスクとなります。
3. 相関と因果の混同(疑似相関の危険)
共分散がどれほど大きな値を示しても、それは「連動して動いている」という事実を示すだけであり、「$X$ が原因で $Y$ が結果である」という因果関係を証明するものではありません。「アイスクリームの売上」と「水難事故の件数」には強い正の共分散が現れますが、これは「気温の上昇」という第3の潜伏変数が両方に影響を与えている疑似相関の典型例です。
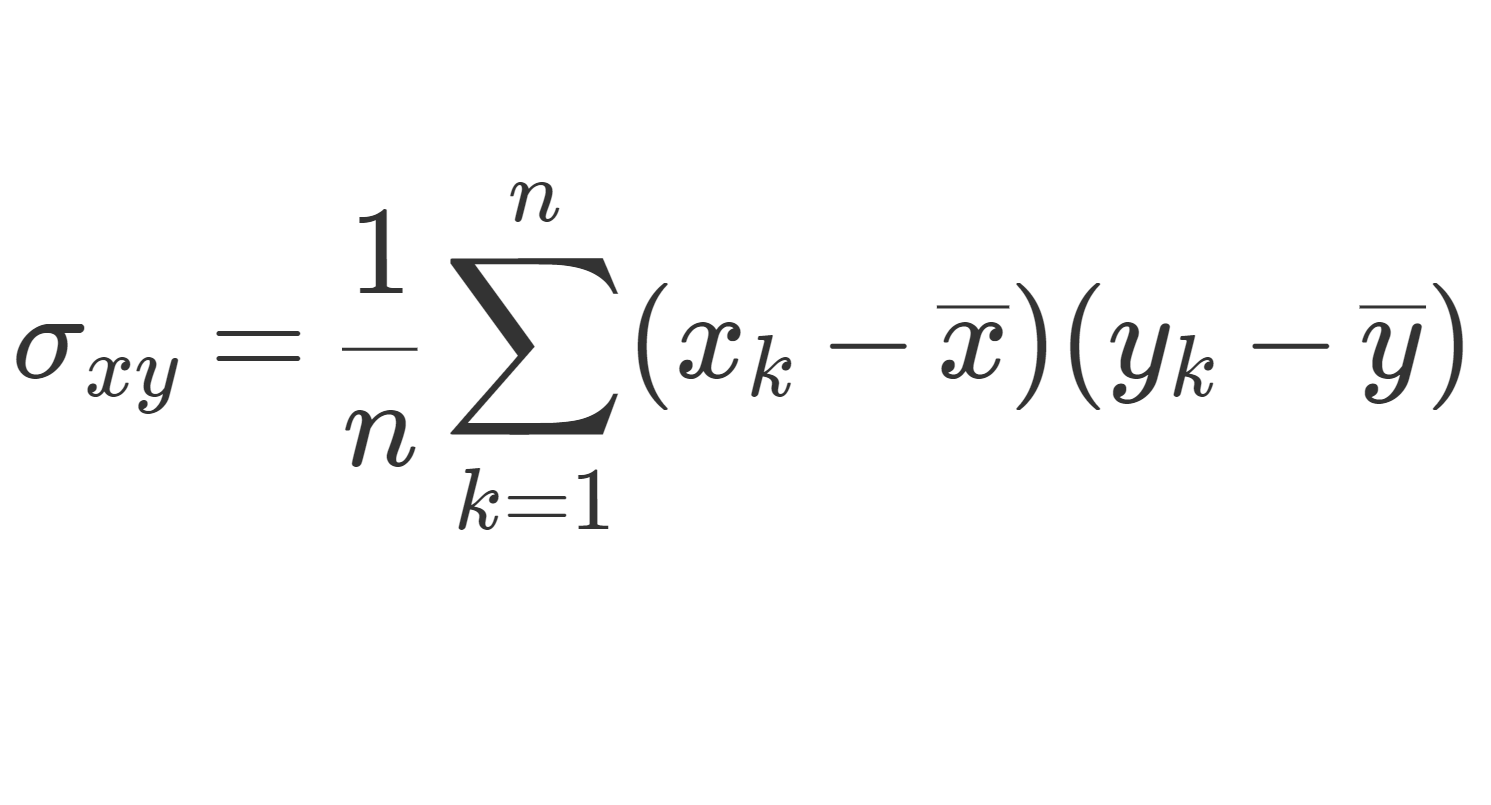
【プロの結論】データリテラシーを高める学習アプローチと実務判断基準
データドリブンな意思決定が叫ばれる現在、共分散をどの深さまで理解すべきかは、学習者の目的や担当する実務領域によって明確に分かれます。
高校生・統計検定3級の受験者
数式の厳密な展開よりも、「偏差の積の平均」という幾何学的な意味と、手計算の表(5ステップ)を淀みなく作れる手順の定着を最優先してください。特に「分散」「標準偏差」「共分散」「相関係数」の相互変換の計算問題を反復することが最短の合格ルートとなります。
ビジネスパーソン・マーケター
手計算に時間を割く必要はありません。Excelの `COVARIANCE.P` と `COVARIANCE.S` の違いを正しく理解し、散布図の描画とセットで「外れ値の有無」や「非線形関係の可能性」を疑える直感を養うことが実務でのバリューに直結します。
データサイエンティスト・機械学習エンジニア
2変数の共分散にとどまらず、線形代数における「分散共分散行列」の固有値分解や多変量正規分布のパラメータとしての数理的挙動を完全に把握する必要があります。次元削減や特徴量エンジニアリングの成否を分ける基盤知識となります。
【共分散の求め方】に関するよくある質問(FAQ)
Q1:共分散がマイナス(負の値)になった場合はどう解釈すればいいですか?
A1:共分散が負の値になった場合は、2つの変数の間に「負の相関」があることを示します。具体的には「一方の数値が平均より大きくなると、もう一方は平均より小さくなる」という逆向きの連動関係がある状態です。例えば「標高の高さと気温」や「製品の価格と販売数量」などの関係で負の共分散が算出されます。
Q2:なぜ共分散だけでなく、わざわざ相関係数まで計算する必要があるのですか?
A2:共分散は元のデータの測定単位に数値の大きさが左右されてしまうためです。例えば「身長(m)と体重(kg)」で計算した共分散と、「身長(cm)と体重(g)」で計算した共分散では、後者の数値が10万倍に跳ね上がってしまい客観的な比較ができません。標準偏差で割って数値を「-1から+1」に規格化することで、単位に関係なく連動の強さを一目で評価できるようにしたものが相関係数です。
Q3:高校数学と大学の統計学で、共分散の公式の分母(n と n-1)が違うのはなぜですか?
A3:対象としているデータの範囲が異なるためです。手元にあるデータそのものが分析対象のすべてである場合(高校数学や全数調査)はデータ数「$n$」で割ります(母共分散)。一方、サンプルデータから背後にある母集団の真の値を偏りなく推測したい場合(大学統計学や標本調査)は、自由度の補正として「$n-1$」で割る不偏推定量(標本共分散)を用います。
Q4:散布図を描かずに共分散だけを計算しても問題ありませんか?
A4:実務上、散布図の確認を省略することは極めて危険です。共分散は外れ値の影響を極端に受けやすく、また「U字型」のような非線形の強い規則性があっても計算結果が0になってしまう欠点があります。必ず散布図を目視で確認し、データの分布傾向を把握した上で共分散や相関係数の値を評価してください。
まとめ:共分散の本質を掴んでデータ分析の次なるステップへ
共分散の求め方は、一見すると無機質な数式の羅列に見えますが、その本質は「2つのデータが平均からどの方向に散らばっているかの面積を合計し、平均化したもの」という極めて幾何学的で直感的な指標です。
単独での強弱比較が難しいという単位依存の弱点はあるものの、相関係数の母体となり、多変量解析や機械学習の根幹を支える極めて重要な基礎統計量であることに変わりはありません。手計算でのメカニズム理解と、Excel関数による実務的な処理手法の両輪をマスターし、確かなデータリテラシーに基づいた分析スキルの習得へと繋げてください。 (出典: 共 分散 求め 方(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
